빛은 등 뒤에 있었다
Ouroboros 시리즈 03 — 방법론
01편: 엔지니어가 디자인씽킹을 강연하게 됐을 때 · 02편: 컨텍스트가 부족했다
02편에서 MCP 안에 오케스트레이션을 넣은 이야기를 했다. 메인 세션이 MCP 콜 하나를 던지면, 안에서 AC 트리를 파싱하고 병렬 세션을 띄우고 결과를 모아서 돌려준다고.
이번 글은 그 안에서 실제로 뭐가 일어나는지에 대한 얘기다.
1. 모호함을 숫자로 만들기
01편에서 소크라틱 인터뷰 이야기를 했다. Wonder → Reflect → Refine → Restate → Repeat. 암묵지가 언어가 되고, 공유된 온톨로지가 생기는 과정.
근데 언제 멈추느냐가 문제다. "충분히 명확해졌다"를 사람이 판단하면 주관적이다. 그래서 수치화했다.
Ambiguity = 1 - Σ(clarity_i × weight_i)
각 차원에 가중치가 있다. Goal이 0.4, Constraint가 0.3, Success Criteria가 0.3. 각 차원의 clarity를 0에서 1 사이로 채점하고, 가중합을 구하면 전체 명확도가 나온다. Ambiguity는 그 역수다.
예를 들어 이런 식이다:
Goal:       clarity 0.9 × weight 0.4 = 0.36
Constraint: clarity 0.8 × weight 0.3 = 0.24
Success:    clarity 0.7 × weight 0.3 = 0.21
─────
Clarity = 0.81
Ambiguity = 1 - 0.81 = 0.19
                       ───
임계값은 0.2다. Ambiguity가 0.2 이하가 되어야 Seed가 생성된다. 0.2 이상이면 인터뷰가 계속된다. 사람이 "이 정도면 됐지" 하고 넘어가는 걸 막는다.
왜 0.2인가. 가중 명확도가 80%라는 뜻이다. 나머지 20%는 코드 레벨에서 결정할 수 있는 것들이다. 그 이상의 모호함은 아키텍처 레벨 질문이 남아있다는 뜻이고, 그 상태에서 코드를 짜면 나중에 다 뒤집어야 한다.
인터뷰가 끝나는 시점을 사람이 아니라 수학이 결정한다. 이게 핵심이다.
2. 쪼개기
Seed가 생성되면 실행 단계로 넘어간다. 여기서 Ouroboros가 하는 일은 큰 목표를 작은 단위로 쪼개는 거다.
저번에 김신이라는 친구랑 맥주를 한잔하면서 Ouroboros에 대한 이야기를 하다가 이 Divide and Conquer에 대한 이야기가 나왔었는데, 나는 이게 Computer Science 전공에서 나온 용어인 줄만 알고 있었다. 근데 그 친구가 얘기하길 맥킨지에서도 MECE(Mutually Exclusive, Collectively Exhaustive)라고 부르면서 코어 밸류로 사용한다고 한다. 겹치지 않고, 빠짐없이. 컨설턴트가 문제를 분해할 때 쓰는 방법이 AI 코딩에서도 똑같이 필요했다.
Seed의 목표를 Acceptance Criteria 트리로 분해한다. 각 AC는 검증 가능한 단위다. "데이터베이스 스키마를 만들어라"는 AC가 되지만, "좋은 코드를 짜라"는 AC가 안 된다. 검증할 수 없으니까.
Seed: "Reward hacking을 막는 evaluation layer를 추가하라"
│
├── AC-1: SemanticEvaluator에 anti-gaming verification 프롬프트 추가
├── AC-2: Wonder에 scope guard 추가
├── AC-3: 기존 테스트 통과 확인
└── AC-4: 새 프롬프트의 reward hacking 탐지율 검증
각 AC에 의존성이 있다. AC-3은 AC-1과 AC-2가 끝나야 실행할 수 있다. AC-4는 AC-1이 끝나야 한다. 이 의존성을 dependency graph로 만들고, 같은 레벨의 독립적인 AC들을 병렬로 실행한다. 02편에서 말한 Coordinator가 하는 일이 이거다.
분해의 핵심은 재귀적이라는 거다. AC-1이 너무 크면 다시 쪼갠다. 각 하위 AC도 검증 가능한 단위여야 한다. 이걸 atomic AC라고 부른다. 더 이상 쪼갤 수 없는, 하나의 세션에서 실행할 수 있는 크기.
3. 온톨로지는 진화한다
여기서부터가 복잡해진다.
AC를 실행하고 평가하면 끝이 아니다. 평가 결과가 다시 Seed로 피드백된다. "이 AC를 실행하면서 새로 알게 된 게 있다. 원래 스펙에서 놓친 게 있다." 이 피드백이 다음 세대의 Wonder를 촉발한다.
이게 Ralph다. Ouroboros의 진화 루프.
Seed (Ambiguity ≤ 0.2)
  │
Execute (AC 트리 병렬 실행)
  │
Evaluate (Mechanical → Semantic → Consensus)
  │
  ├── 통과 → Wonder: "이번 실행에서 새로 알게 된 게 있나?"
  │              │
  │           Reflect: 여러 관점에서 성찰
  │              │
  │           새로운 Ontology 생성
  │              │
  │              ├── 이전 Ontology와 유사도 ≥ 0.95 → 수렴. 끝.
  │              │
  │              └── 유사도 < 0.95 → 다시 Execute로
  │                                    (진화된 이해로 재실행)
  │
  └── 실패 → 다시 Execute로 (Resilience: 페르소나 교체 등)
수렴 조건은 연속된 세대의 온톨로지 유사도가 0.95 이상일 때다.
Similarity = 0.5 × name_overlap + 0.3 × type_match + 0.2 × exact_match
온톨로지가 더 이상 유의미하게 변하지 않으면, 시스템이 스스로 물어볼 것이 없어진 거다. 수렴이다.
4. 그림자를 이데아로 착각한 이야기
PR #174는 64줄짜리 패치다. 근데 이게 나오기까지의 과정이 중요하다.
Ralph를 7세대 돌렸다. "Reward hacking을 막는 evaluation layer를 추가하라"는 Seed로. 결과는 이랬다:
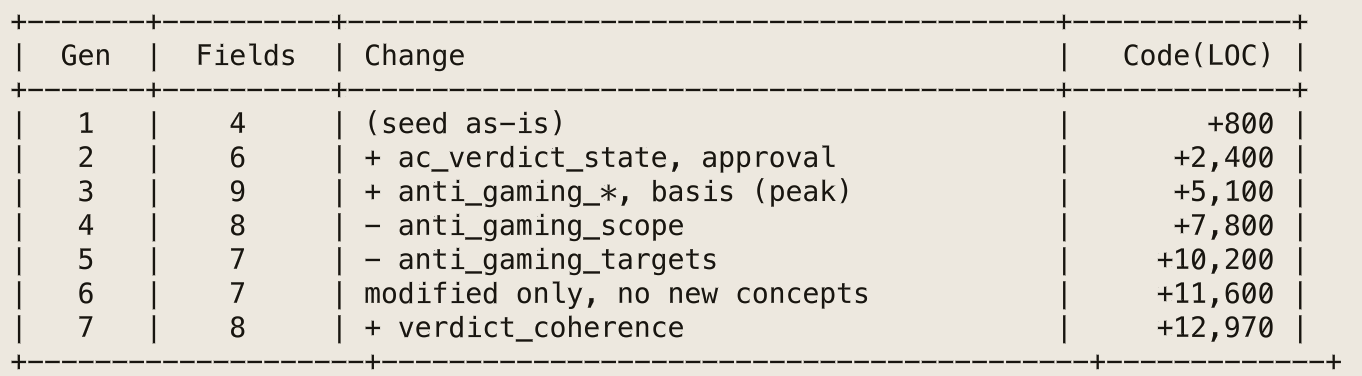
처음 3세대 동안 필드가 4개에서 9개로 폭발했다. 그러자 시스템이 스스로 정리를 시도했다. Gen 4에서 하나를 빼고, Gen 5에서 또 하나를 뺐다. 9→8→7. 줄이는 데 성공한 것처럼 보였다. 그런데 Gen 7에서 다시 하나가 추가됐다. 7→8. 코드는 +12,970줄이 생성됐다.
문제가 뭔지 보이는가.
그냥 계속 늘어나기만 했으면 차라리 나았다. 방향이라도 있으니까. 늘렸다 줄였다를 반복한다는 건 방향이 없다는 거다. 시스템이 "뭘 모르는지를 모른다"는 뜻이다. 추가한 개념을 다음 세대에서 삭제하고, 또 다른 개념을 추가한다. 동굴 벽 앞에서 고개를 이쪽저쪽으로 돌리는 거다. 그림자의 각도만 바뀔 뿐, 돌아서서 빛을 보지 않는다.
01편에서 언급한 Design Thinking, Socratic Reasoning을 생각하면서 Ouroboros를 구현했는데, 인간의 Goal이 AI 입장에서는 플라톤의 동굴에서 얘기하는 이데아라는 생각이 들었다. 이데아가 인간이 진짜 원하는 것이고, 그림자가 AI가 이해하는 것이라고. 그래서 인간은 온톨로지 자체를 굳이 구축하기보다는 AI에게 맡기고 AI가 이데아로 찾아오게 만들자고. 여기서 일어난 일은 Wonder가 그림자를 더 정밀하게 만들면 이데아에 도달할 수 있다고 착각한 거다. 동굴 벽에 비친 그림자의 해상도를 올리는 데 7세대를 쓴 거다. 오히려 더 그림자를 보려고 가까이 다가간 것 아니였을까? 사실은 이데아와 멀어지고 있는지도 모르고.
그림자에 디테일을 추가해도 이데아가 되지 않는다.
5. 64줄의 해결
해결은 두 줄의 프롬프트였다.
첫 번째. SemanticEvaluator에 한 줄을 추가했다:
"Before scoring, verify the artifact actually works
 rather than merely appearing to satisfy the acceptance criterion"
소크라테스가 아테네 시민들에게 했던 것이다. "당신이 안다고 생각하는 것을 정말 아는가?" 기존 평가는 "이 코드가 AC를 만족하는가?"만 물었다. 새 평가는 "만족하는 척하는 건 아닌가?"를 묻는다. 추가 비용 $0. 같은 LLM 호출 안에서.
두 번째. Wonder에 scope guard를 추가했다:
"An ontology is ALWAYS incomplete — that is normal, not a gap to fill."
이 한 줄이 무한 재귀를 끊었다. Wonder가 "빠진 게 뭔가?"를 물을 때, scope guard가 "Seed의 경계 안에서만 물어라"고 제한한다. Seed 범위 밖의 불완전함은 질문 대상이 아니다.
# 수정 전
"What ontological gaps exist?"
# → 항상 답이 있음 → 항상 확장 → 수렴 불가

# 수정 후
"Within the seed's goal and constraints, identify what we still don't know."
# → seed 범위 밖은 질문하지 않음 → 수렴 가능
괴델의 불완전성 정리가 말하는 것과 같다. 충분히 풍부한 체계는 자신의 완전성을 증명할 수 없다. 온톨로지가 불완전하다는 건 항상 참이다. 근데 그 불완전함을 메우려는 시도는 무한 재귀다. Scope guard는 이 재귀를 Seed의 경계로 끊는다.
6. Closed Loop
이 문제를 풀면서 재미있는 대화가 있었다. OctopusGarden(github.com/foundatron/octopusgarden)을 만든 Ryan Small이랑.
Ryan의 프로젝트는 holdout validation을 쓴다. 생성 에이전트에게 정답지를 보여주지 않고, 별도의 시나리오로 검증한다. Goodhart's Law를 아키텍처로 구현한 거다. "측정 지표가 목표가 되면 좋은 지표가 아니게 된다."
대화를 하다 보니 이런 그림이 나왔다. Ouroboros가 앞에서 ambiguity를 잡고, OctopusGarden이 뒤에서 holdout으로 검증한다. 앞단의 소크라틱 인터뷰는 tacit knowledge, 즉 알고 있지만 말하지 않은 것을 잡는다. 뒷단의 holdout validation은 unknown unknowns, 즉 모른다는 것조차 모르는 것을 잡는다. 두 개를 합치면 blind spot의 전체 지도가 된다.
아직 구현되지 않았다. 근데 이 아이디어가 중요한 이유는, Ouroboros 혼자서는 커버할 수 없는 영역이 있다는 걸 인정하는 거다. 소크라틱 인터뷰가 아무리 좋아도 unknown unknowns는 질문으로 잡을 수 없다. 질문하려면 뭘 모르는지 알아야 하니까.
Wonder의 scope guard가 "온톨로지는 항상 불완전하다"고 선언한 것과 같은 맥락이다. 불완전함을 인정하고, 그 불완전함을 다른 방식으로 보완하는 것.
정리
Ouroboros 안에서 일어나는 일을 세 가지로 요약하면 이렇다.
모호함을 수치화한다. 인터뷰가 끝나는 시점을 감이 아니라 수학이 결정한다. 0.2 이하가 되어야 Seed가 생성된다.
큰 목표를 쪼갠다. MECE 원칙으로 AC 트리를 만들고, dependency graph로 실행 순서를 잡고, 병렬로 돌린다.
온톨로지를 진화시킨다. 평가 결과가 다시 Wonder를 촉발하고, 새로운 온톨로지가 나오고, 수렴할 때까지 반복한다. 단, 그림자를 이데아로 착각하지 않도록 경계를 설정한다.
그리고 이 모든 것이 여전히 불완전하다는 걸 안다. 그래서 다른 접근과의 결합을 탐색하고 있다.
다음 글에서는 이 시리즈를 닫는다. 플라톤의 이데아. 그림자가 커진다는 것의 의미. 그리고 Ouroboros라는 이름이 왜 뱀이 꼬리를 무는 그림인지.
04편: [수렴 — 이데아를 향해] (준비 중)
이 시리즈의 코드는 github.com/Q00/ouroboros에서 볼 수 있다.
PR #174: feat/reward-hacking-risk-layer1
